アプリ一覧公開日 2026-10-12
| 種別 | Hexo プラグイン Node.js 20.19 以上で動作。動作を確かめているのは Hexo 8.1.2 と Node.js 24 です |
|---|---|
| 使用技術 | JavaScript(意味ベクトルを使うときは Transformers.js) |
| ライセンス | MIT ライセンス(無料) |
| データ保存 | 意味ベクトルを使うときだけ、Hexo ブログのプロジェクトの .yukari-cache/ にモデルとベクトルを置く |
概要
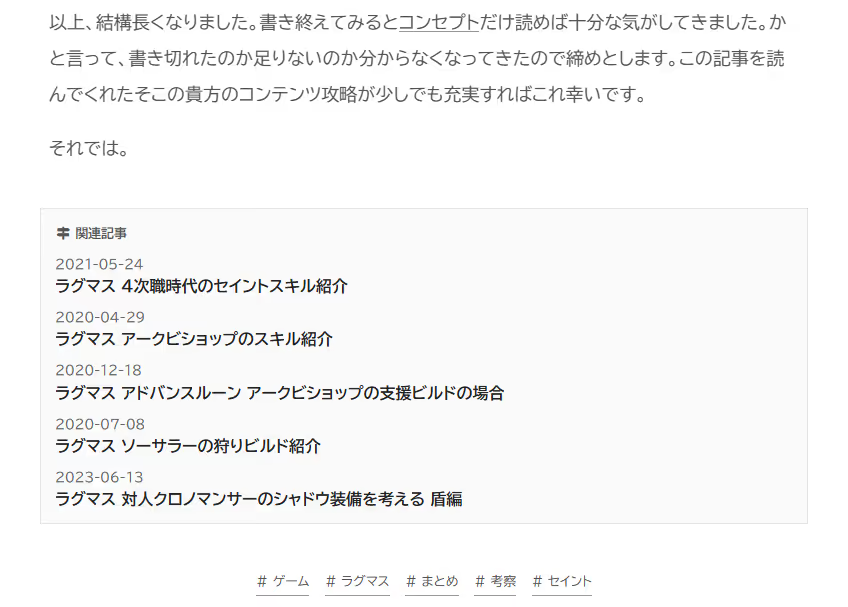
日本語の記事に特化した Hexo の関連記事プラグインです。辞書や人間による判定を使わず、記事のタイトルと本文だけから「ゆかりのある記事」を選びます。このブログの記事の末尾にある「関連記事」も、このプラグインで選んでいます。
主な特徴
- 辞書を使わずに日本語を語に分ける(漢字・カタカナ・英数字の連続を語とみなし、ひらがなを捨てる)
- 関連の近さを両方向の順位で測る(mutual proximity)。調整する値は表示件数だけ
- 同じシリーズの記事ばかりを並べない
- 本文ですでにリンクしている記事は出さない
- 新しい記事を先に出す
- 日本語の文章埋め込みモデル ruri-v3-30m による意味ベクトルを、任意で使える(本文の語との併用もできる)
導入
1 | npm install hexo-yukari |
関連記事は、テーマに page.related_posts(記事のパスの配列)として渡します。NexT はこの形をそのまま表示できるので、テーマの設定で related_posts.enable: true にするだけで使えます。表示件数などは、Hexo ブログのプロジェクトの _config.yml に書きます。
1 | yukari: |
このブログでの使い方
本文の語と意味ベクトルを併用し、意味ベクトルの計算には GPU(WebGPU)を使っています。関連記事の欄は、サイドバーではなく本文の末尾に置いています。
1 | yukari: |
使うときの注意
- 計算量は記事数の3乗に比例して増えます。このブログの372記事では、判定に約0.4秒かかります
- 意味ベクトルを使うときは、最初の生成でモデル(約147MB)を取得します。2回目以降は、変わった記事だけを計算します
設定の一覧や関連記事を選ぶ仕組みは、GitHub の README にまとめています。